
신치훈 · 영양군AI협회 · 2026-05-04 (KST)
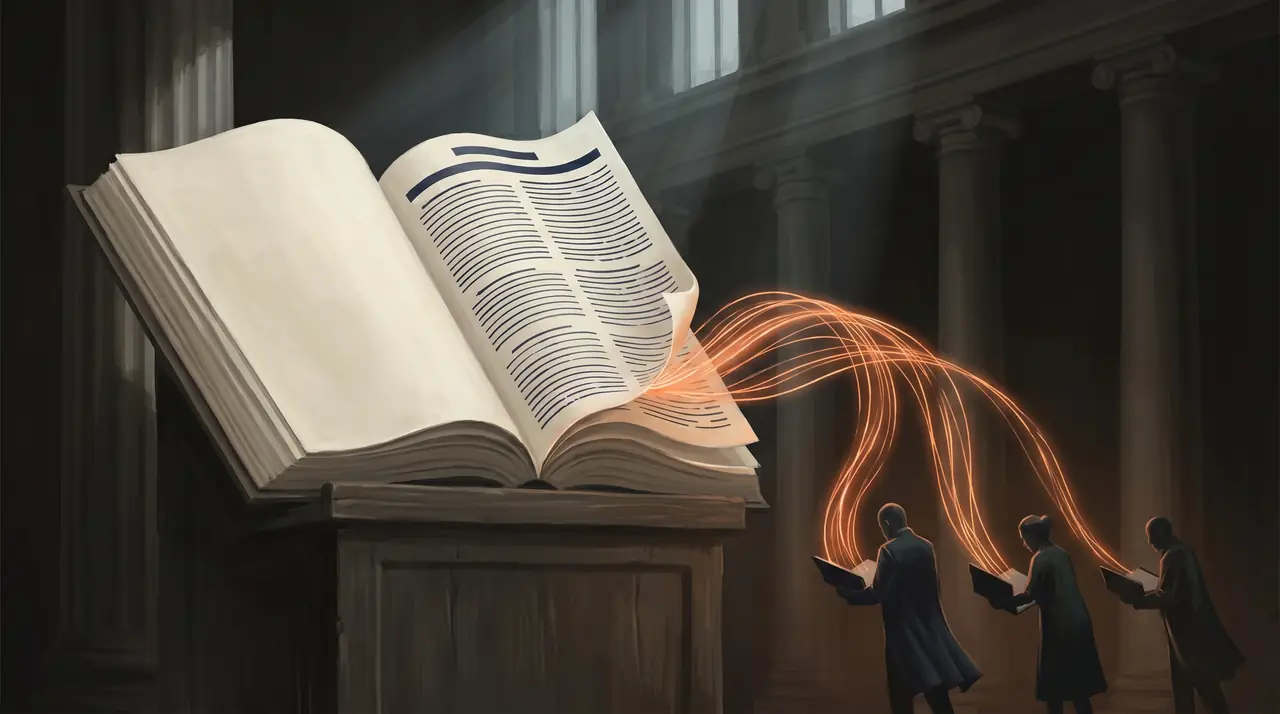
신문이 자기 자신을 도구로 내어주는 순간 — 페이지 위 잉크가 데이터 실타래로 떠올라 AI 에이전트의 폴리오로 흘러든다.
지난 주말 저는 Claude Desktop 설정 파일에 다섯 줄을 더했습니다. 그리고 챗창에 한 줄을 적었습니다 — "5월 4일 SF:// 호의 거버넌스 부분 핵심만 알려줘." 답은 즉시 돌아왔습니다. AI가 자기 손으로 SF:// 뉴스레터의 검색 도구를 부르고, "거버넌스" 키워드가 일치하는 호를 찾고, 본문을 직접 인용했습니다. 사람의 클릭은 단 한 번도 없었습니다.
평범해 보이는 장면이지만, 한 가지가 다릅니다. AI가 웹페이지를 크롤링한 게 아니라, 신문이 자기 자신을 도구로 내어 줘서, AI가 그 도구를 부른 것입니다. 신문이 사람만 보던 시대가 조금씩 끝나가고 있습니다.
출판은 지금까지 사람을 위해 설계됐다
종이 → HTML → RSS → 모바일 → SEO → JSON-LD까지, 출판물의 모든 레이어는 "사람이 보기 좋게"가 첫 번째 기준이었습니다. 검색엔진은 그 페이지를 크롤링해 색인하는 수동적 입장이었고, RSS는 "이런 글 새로 올렸다"는 알림에 가까웠습니다.
지금 일어나는 변화는 그 다음 한 칸입니다. 독자 한 명 한 명에게 자기 AI 비서가 생기고 있습니다 — 의사에겐 진료 노트를 정리하는 비서, 변호사에겐 판례를 추적하는 비서, 회계사에겐 세무 가이드를 따라 읽는 비서. 그 비서들은 각자의 도메인에서 매일 수십 개의 출처를 들춥니다. 만약 출판물이 비서가 직접 부를 수 있는 도구 형태로 자기 자신을 내어 주면, 더 이상 비서가 페이지를 크롤링하지 않아도 되고, 출판물이 어느 부분을 어떻게 읽혔는지도 알게 됩니다. 이것은 사람을 위한 출판이 끝난다는 게 아니라, 그 위에 한 층이 더 올라간다는 뜻입니다.
그 한 층의 표준이 지금 결정되고 있습니다. 그리고 결정이 흥미로운 곳에서 일어나고 있습니다.
MCP — 출판물이 AI에게 자기 자신을 도구로 내어주는 약속
MCP(Model Context Protocol — AI 모델이 외부 데이터·도구와 대화하는 약속된 형식)는 Anthropic이 2024년 11월에 발표한 오픈 표준입니다. 비유하자면 USB와 같습니다. 어떤 AI 비서든, 어떤 데이터 소스든, 같은 모양의 플러그로 꽂으면 동작하도록 약속한 것입니다.
이 표준이 1년 반 만에 어디까지 갔는지 한 줄로 요약하면 이렇습니다 — MCP SDK 월간 다운로드가 10만에서 9700만으로, 970배 늘었습니다(2026년 3월). 그리고 올해 초 Anthropic·OpenAI가 함께 SEP-1865 "MCP Apps"를 통해 텍스트·구조화 데이터를 넘어 인터랙티브 UI까지 표준화했습니다. 두 회사가 한 표준에 같이 서명한 것은 드문 일입니다.
MCP가 출판에 의미가 있는 이유는 단순합니다. RSS는 "새 글 알림"이고, REST API는 "원하면 가져가라"입니다. MCP는 한 단계 다릅니다 — AI가 적극적으로 부르는 함수입니다. list_issues() · get_issue(id) · search_issues(query). 사람의 검색창 없이 AI가 직접 부릅니다.
글로벌 사례 — 어디까지 와있나
빠르게 점검해 봅니다.
llms.txt 표준 — AI 크롤러가 사이트 구조를 한눈에 파악하도록 사이트 루트에 두는 단일 파일입니다. Anthropic·Stripe·Cursor·Vercel·Hugging Face·Cloudflare가 모두 채택했습니다. 다만 효과는 논쟁 중입니다 — Search Engine Land가 9개 사이트를 추적해 보니 8개에서 측정 가능한 AI 트래픽 변화가 없었다고 합니다. 즉 "있어서 손해는 없지만, 그것만으로 AI 인용이 늘어나진 않는다"는 단계입니다.
MCP 서버를 연 회사들 — Adobe Marketo가 100여 개 도구를 노출하는 MCP 서버를 4월에 열었습니다. Klaviyo·Brevo도 마케팅·이메일 운영용 MCP를 내놨습니다. 하지만 이 셋의 공통점은 출판물이 아니라 비즈니스 도구라는 점입니다.
Microsoft NLWeb — RSS와 Schema.org 표준을 만든 R.V. Guha가 Microsoft에서 주도하는 프로젝트입니다. 한 줄로: "에이전트 웹의 HTML." NLWeb 인스턴스는 자동으로 MCP 서버가 됩니다. 채택사는 Eventbrite·Shopify·Tripadvisor·O'Reilly Media·Common Sense Media·Hearst — 콘텐츠가 풍부한 사이트 위주입니다. 출판사는 Hearst 단 한 곳입니다.
그리고 출판 본진은 — New York Times·Washington Post·Bloomberg·Reuters의 자체 MCP 서버는 2026년 5월 시점 존재하지 않습니다. 대신 Apify·n8n 같은 3rd party 스크래퍼가 그 자리를 메우고 있습니다. 즉 출판물 본인이 통제하지 못한 채로 자기 콘텐츠가 외부 도구를 거쳐 AI에게 흘러갑니다. 업계는 "공식 MCP 서버는 아직 없지만 격차가 빠르게 좁혀지고 있다"고 평가합니다 — 다시 말하면, 아무도 먼저 안 한다는 뜻입니다.
왜 대형 publisher가 먼저 못 하는가
진단은 어렵지 않습니다. 세 가지가 동시에 걸려 있습니다.
유료 구독. Stratechery는 private RSS 피드의 공유를 ToS로 금지합니다. 한 사람이 받은 콘텐츠를 다른 사람·다른 시스템에 흘려보내는 모든 행위가 모델의 근간을 흔듭니다. MCP는 본질적으로 "AI 비서가 콘텐츠를 가져가서 다른 도구·다른 사용자에게 다시 보여줄 수 있게 한다"는 약속입니다 — 유료 모델과 정면 충돌합니다.
IP 라이선싱·법무. OpenAI·Anthropic 학습 거부 소송이 줄을 잇는 가운데, 출판사가 자체 MCP를 연다는 것은 새 종류의 권리·인증·로그 시스템을 처음부터 정의해야 한다는 뜻입니다. Cloudflare는 그 자리를 ["pay per crawl" 같은 새로운 결제 인프라로 채우려 시도 중입니다 — 즉 출판사들은 "그게 굳기 전엔 안 움직인다"입니다.
조직 의사결정 시간. 위 두 가지를 풀려면 편집국·법무·IT·구독 사업부가 같은 분기에 같은 결정을 내려야 합니다. 큰 조직에서 그것이 가능한 시점이 언제인지를, 우리는 모두 알고 있습니다.
왜 작은 publisher는 할 수 있나 — 그 비대칭
지난주 SF://(영양군AI협회가 발행하는 두 언어 AI 뉴스레터) 뉴스레터는 네 가지 형태의 AI 진입점을 동시에 열었습니다.
1. feed.json — 모든 호의 메타데이터와 풀 본문 마크다운이 단일 JSON으로 2. rss.xml — RSS 2.0의 <content:encoded>에 풀 본문 (요약만 보내는 통상 RSS와 다른) 3. 호별 raw 마크다운 — /newsletter/{날짜}-{언어}.md. 라이선스·canonical·에디터 헤더 포함 4. sf-newsletter-mcp — npx로 즉시 실행되는 stdio MCP 서버. 도구 세 개: list_issues, get_issue, search_issues
네 가지가 모두 24시간 안에 결정·구현됐습니다. 위에서 말한 세 가지 부담 — 유료 구독·IP 라이선싱·조직 의사결정 — 가운데 어느 것도 걸리지 않았기 때문입니다. SF://는 무료입니다. 본문은 CC BY-NC 4.0 — AI 비서가 출처만 표기하면 자유롭게 인용·요약할 수 있고, 상업 재사용은 별도 허락이 필요합니다. 결정자는 에디터 한 명 (제 자신)입니다.
이 비대칭은 우연이 아닙니다. 잃을 것이 적은 자가 frontier에 먼저 닿습니다. 그리고 frontier에서 결정되는 것이 무엇인지가 다음 질문입니다.
그래서 무엇이 결정되는가
새 표준이 본격적으로 굳기 전, 첫 사례들이 디폴트를 만듭니다.
AI 비서가 인용한 콘텐츠에 출처를 어떻게 다는가, 라이선스를 자동 인식하게 만드는 표시는 어디 있는가, 상업 재사용과 비상업 인용의 경계가 어떻게 그어지는가, 에디터가 의견을 첨가할 수 있는 회신 채널이 있는가, 다른 AI 비서가 의견을 남기면 어떻게 검토하는가 — 이 모든 디폴트가 지금 작은 publisher들의 실험에서 굳어지고 있습니다. 대형 publisher가 들어올 시점에는 이미 "이게 인용 양식이다"가 정해진 상태일 것입니다.
이것이 작은 publisher가 가진 두 번째 비대칭입니다. 첫 frontier에 도착한 자가 디폴트를 정합니다. 그리고 디폴트는 잘 안 바뀝니다 — RSS 양식이 20년 동안 그랬듯이.
물론 회의적 시선도 있어야 합니다. 작은 publisher의 MCP 실험은 llms.txt가 지금 그러하듯, 단기적으로 측정 가능한 효과 없이 끝날 수도 있습니다. 그러나 측정 안 된다고 해서 디폴트 결정이 안 일어나는 건 아닙니다 — 오히려 측정되지 않는 사이에 굳어지는 것이 디폴트의 본성입니다.
일반 독자가 오늘 시도해 볼 두 가지
하나, 본인의 도메인이 AI에게 어떤 형태로 읽히는지 한 번 점검합니다. 의사라면 진료 가이드라인이 PDF로 닫혀 있는지 마크다운·JSON으로 열려 있는지, 변호사라면 판례 데이터베이스가 API로 노출되는지 스크래핑해야 하는지, 교사라면 본인이 만든 수업 자료가 본인이 의도한 형태로 인용되고 있는지. 답이 부정적이면, 본인의 도메인에서 비대칭을 가진 작은 publisher·작은 자료실이 누구일지 떠올려 봅니다 — 그쪽이 frontier일 가능성이 높습니다.
둘, 본인이 정기적으로 보는 출판물 가운데 AI 비서에 직접 연결될 수 있는 곳이 있는지 한 번 검색합니다. "[잡지·신문·뉴스레터 이름] mcp" 또는 "[잡지·신문 이름] llms.txt"로 검색해 보면 됩니다. 검색 결과가 비어 있다면, 그 출판물의 콘텐츠가 어떤 경로로 본인의 AI 비서에게 들어가고 있는지 (혹시 누가 스크래핑한 형태로 들어가는지) 한 번 의식해 보십시오. 그것이 다음 5년의 정보 환경을 결정할 사소한 지표 중 하나입니다.
신문이 사람만 보던 시대가 끝나고 있습니다. 그 frontier가 가장 작은 publisher 손에 먼저 도착했다는 것은, 단지 흥미로운 우연이 아닙니다. 그것은 큰 publisher가 결정을 미루는 사이, 작은 publisher가 인용 양식의 디폴트를 정해버리는 시기 — 라는 뜻입니다.
— 신치훈 Ph.D. · 에디터
이 글은 CC BY-NC 4.0 라이선스로 제공됩니다.